Nettoyer une base sans fermer les portes d'entrée, c'est prendre rendez-vous avec les mêmes doublons dans six mois. La détection et la fusion sont traitées dans le guide complet sur les doublons HubSpot ; celui-ci s'occupe de l'amont. Les doublons entrent par quatre portes, toujours les mêmes : les imports, les formulaires, les intégrations et la saisie manuelle. Chacune se ferme, à condition de savoir ce que HubSpot vérifie et, surtout, ce qu'il ne vérifie pas.
Ce que HubSpot vérifie tout seul : l'email exact
À la création d'un contact, HubSpot cherche si l'adresse email existe déjà : si oui, il met à jour la fiche existante au lieu d'en créer une seconde. Côté entreprises, le même mécanisme joue sur le nom de domaine. C'est la protection de base, et elle est fiable, mais elle ne couvre que l'identité exacte.
Les imports : l'identifiant unique ou la fiche en double
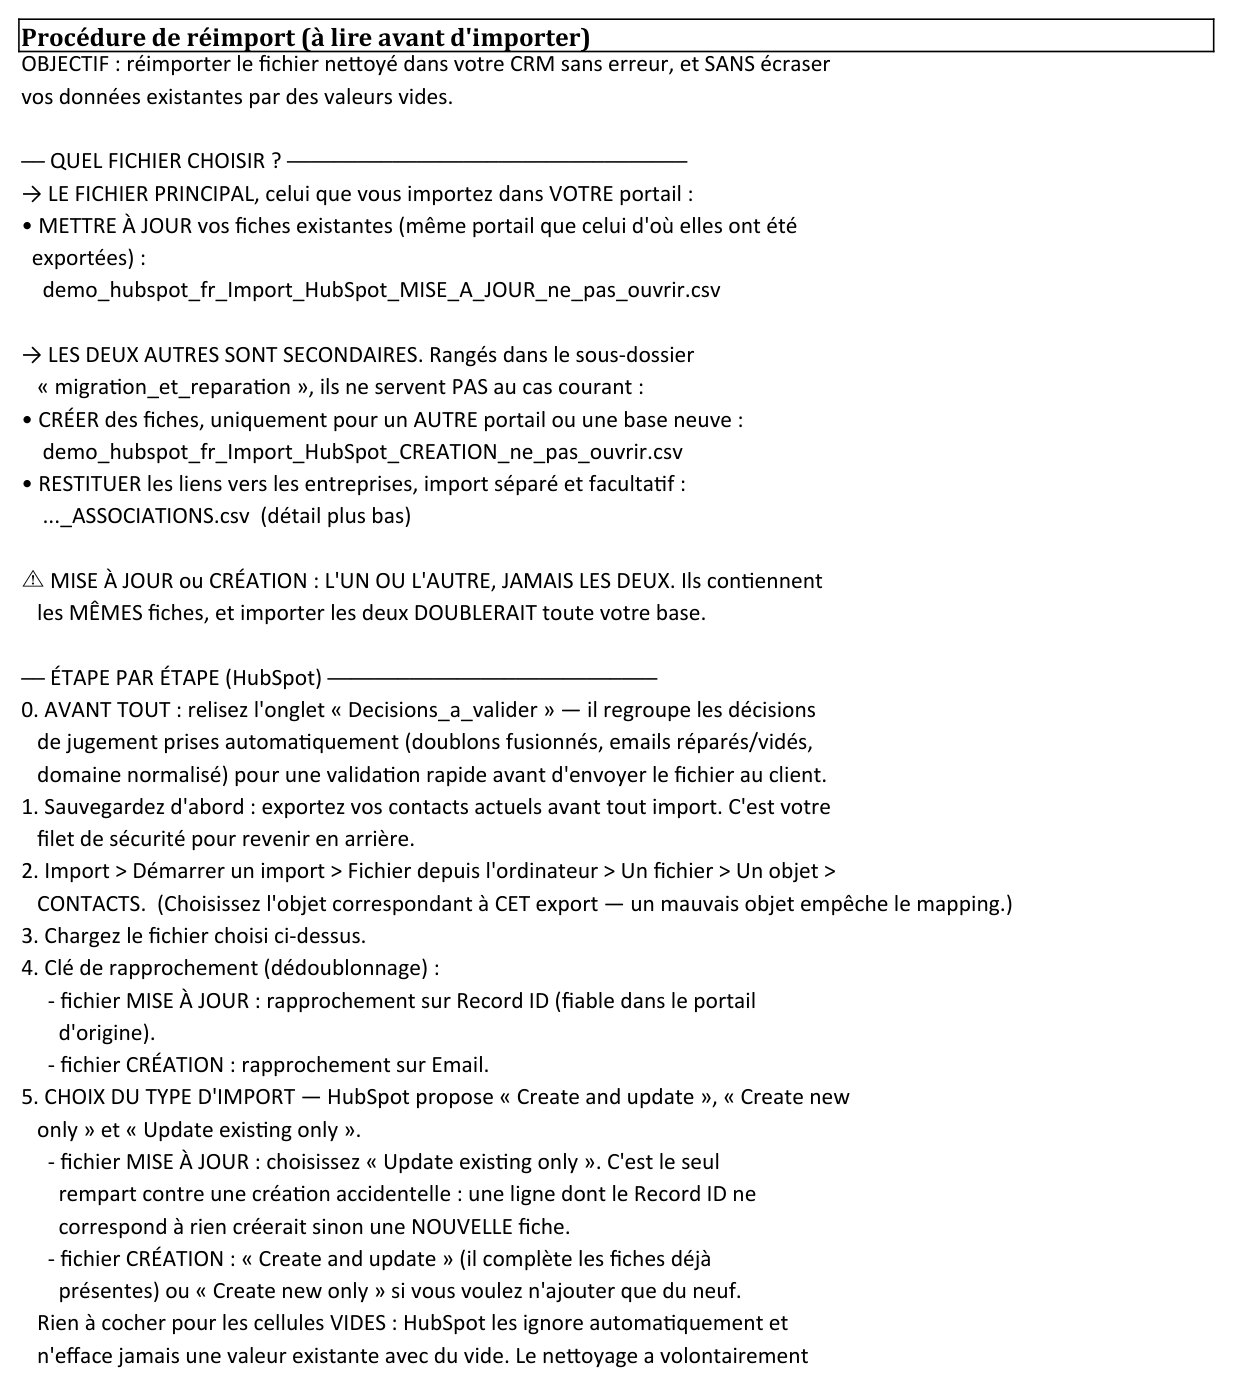
C'est la porte principale, et la règle est mécanique. Si votre fichier d'import porte un identifiant unique (l'email ou le Record ID pour les contacts, le domaine ou le Record ID pour les entreprises), HubSpot rapproche chaque ligne d'une fiche existante et la met à jour. S'il n'en porte pas, chaque ligne devient une fiche neuve : l'import d'une liste de salon sans colonne email fabrique un doublon par participant déjà connu.
Deux points rassurants au passage : une cellule vide dans le fichier n'efface pas la valeur existante de la fiche, elle est simplement ignorée ; et un rapprochement par Record ID fonctionne même quand l'adresse email a changé entre temps. C'est pour cela que la colonne Record ID doit survivre à tous vos allers-retours Excel, comme l'explique le guide d'export des contacts HubSpot.
Les formulaires : une porte à moitié fermée
Quand un visiteur soumet un formulaire avec une adresse déjà connue, HubSpot enrichit la fiche existante : pas de doublon. La faille est ailleurs : la même personne qui revient avec une autre adresse, souvent la perso après la pro, ouvre une seconde fiche que rien ne rattache à la première. À savoir aussi : les propriétés personnalisées à valeur unique, qui bloquent les doublons à l'import, ne s'appliquent pas aux formulaires. La parade est d'abord rédactionnelle : demander l'adresse professionnelle explicitement, et réserver les champs libres au strict nécessaire.
Les intégrations : la porte qu'on oublie
Outil de facturation, plateforme de webinaires, enrichissement : chaque outil branché sur HubSpot crée ou modifie des fiches selon ses propres règles de rapprochement, pas selon les vôtres. La documentation HubSpot en donne un exemple précis : une entreprise créée par API n'est pas dédupliquée sur le nom de domaine. Le réflexe à prendre pour chaque intégration : identifier sur quel champ elle rapproche les fiches, faire un test avec un contact déjà présent, et regarder si elle a mis à jour ou créé. Une intégration mal réglée fabrique des doublons plus vite que toute une équipe commerciale.
La saisie manuelle : une règle d'équipe
Le commercial pressé qui crée une fiche sans chercher l'existant reste une source classique. La réponse n'est pas un outil, c'est une règle d'équipe courte et connue : chercher par email, puis par nom d'entreprise, avant toute création. Elle coûte dix secondes par fiche et s'installe en une réunion. Le signe qu'elle manque se lit dans la base : des fiches sans propriétaire et sans source, apparues en dehors de tout import, comme celles que décrit le guide sur les leads sans propriétaire.
Le contrôle périodique, même quand tout est bien réglé
Les quatre portes fermées réduisent le flux, elles ne l'annulent pas : les variantes d'email passent au travers par construction. D'où un contrôle régulier, avec l'outil natif de gestion des doublons pour les paires simples, ou par export et clé de rapprochement au-delà. Une base active mérite ce contrôle chaque mois : dix minutes quand tout va bien, et c'est précisément le signe que la prévention fonctionne.
Par où commencer chez vous
L'ordre efficace est l'inverse de l'ordre intuitif. Commencez par mesurer le stock existant, parce qu'il dit par quelle porte vos doublons sont entrés : des paires exactes en masse signalent un import sans identifiant, des variantes d'adresse signalent les formulaires, des fiches jumelles sans source signalent une intégration. Puis fermez la porte qui domine, et seulement ensuite traitez le stock, méthodiquement, comme décrit dans le guide de déduplication en masse. Sur la base de démonstration d'Inspectable, entièrement synthétique, 36 groupes de doublons sur 1 400 contacts : le diagnostic désignait les imports successifs comme porte principale, et c'est là que la prévention devait commencer.
Sources
Chaque page ci-dessous a été ouverte et lue. Ce sont des sources primaires : l’autorité qui édicte la règle, ou l’éditeur du logiciel.
- Deduplicate records in HubSpotHubSpot, base de connaissances. La déduplication automatique : email exact pour les contacts, domaine pour les entreprises, et ses exceptions, dont l'API.
- Format import filesHubSpot, base de connaissances. Les identifiants uniques qu'un fichier d'import doit porter pour mettre à jour au lieu de créer.
Par quelle porte entrent vos doublons ?
Le mini-audit gratuit mesure votre stock de doublons en 24 h, à partir d'un simple export, sans accès à votre portail. Le rapport complet en identifie les origines, porte par porte.
Obtenir mon mini-audit gratuit